
“검색결과에서 숨기고 싶으니 robots.txt로 막자”는 흔한 실수입니다. 봇이 페이지를 읽지 못하면 그 안의 noindex도 읽을 수 없습니다. 먼저 크롤링과 색인을 구분하세요.
세 가지 신호의 역할
| 신호 | 위치 | 주요 목적 |
|---|---|---|
| robots.txt | 도메인 루트의 텍스트 파일 | 어떤 봇이 어떤 경로를 크롤링할 수 있는지 관리 |
| meta robots | HTML <head> | HTML 페이지의 색인·링크 추적·스니펫 동작 제어 |
| X-Robots-Tag | HTTP 응답 헤더 | HTML뿐 아니라 PDF·이미지 같은 파일에도 robots 지시 적용 |
<meta name="robots" content="index, follow">

HTTP/2 200
X-Robots-Tag: noindex
robots.txt는 비밀 보관 장치가 아닙니다.공개 파일이므로 누구나 읽을 수 있고, URL이 다른 곳에서 링크되면 크롤링이 차단되어도 주소 자체가 검색결과에 나타날 수 있습니다. 민감한 정보는 로그인·권한으로 보호하세요.
Meta Checker로 페이지 지시 확인하기
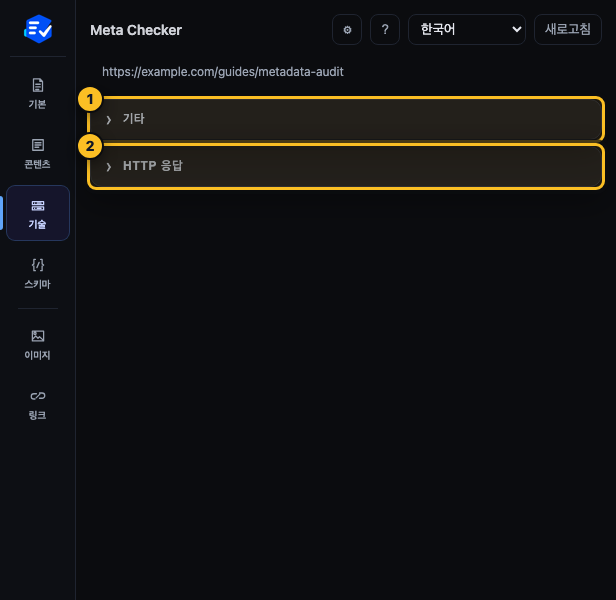
- 1기타 정보의
robots행은 HTML 메타 태그입니다. - 2HTTP 응답의
x-robots-tag는 서버 헤더입니다. 둘 다 있으면 더 제한적인 지시가 적용될 수 있으므로 충돌을 없애세요.
Meta Checker의 기술 탭을 엽니다
‘기타 정보’와 ‘HTTP 응답’ 섹션이 접혀 있다면 제목을 눌러 펼칩니다.
robots 값을 읽습니다
index, follow, noindex, nofollow, nosnippet 등을 확인합니다. N/A는 명시 태그가 없다는 뜻이며 곧바로 noindex라는 뜻은 아닙니다.
X-Robots-Tag를 함께 봅니다
meta robots가 index인데 HTTP 헤더가 noindex라면 의도와 다른지 확인합니다.
New·Changed 상태를 확인합니다
robots 지시가 자바스크립트로 뒤늦게 바뀌지 않도록 최초 HTML 또는 HTTP 응답에서 명확하게 전달하는 것이 좋습니다.
robots.txt는 브라우저에서 직접 확인합니다
Meta Checker는 현재 페이지의 robots 태그와 응답 헤더를 보여 주지만, 사이트 전체의 robots.txt 파일을 분석하지는 않습니다. 주소창에 도메인 뒤 /robots.txt를 붙여 직접 여세요.
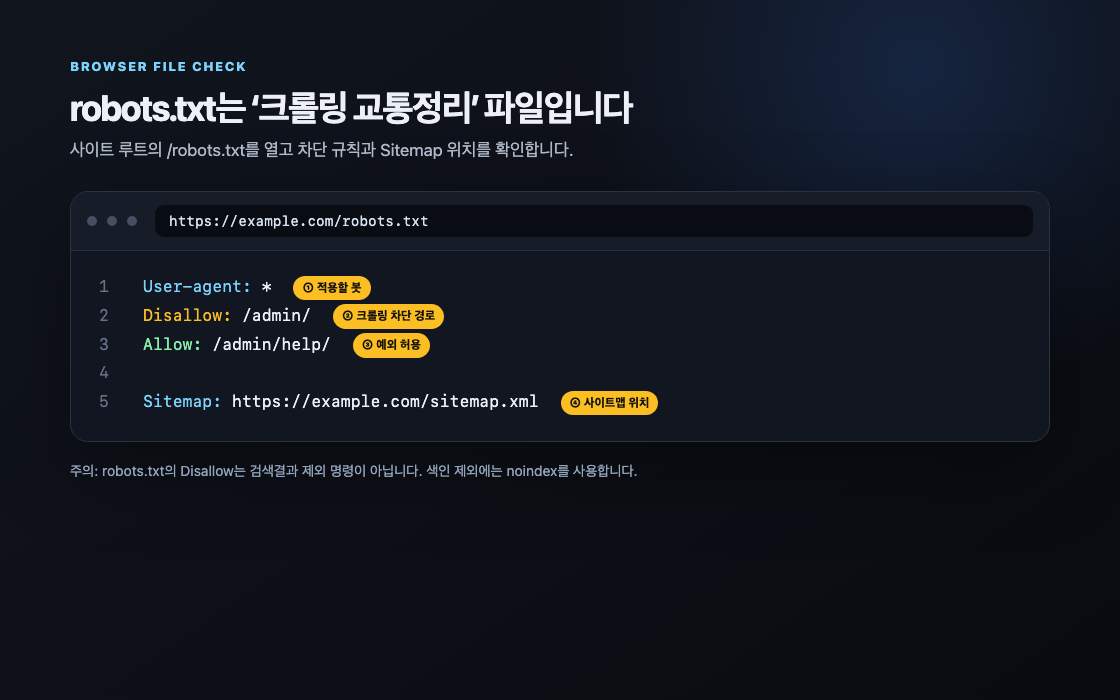
https://example.com/robots.txt- 1
User-agent: 규칙을 적용할 봇 - 2
Disallow: 크롤링을 허용하지 않을 경로 - 3
Allow: 차단 경로 안에서 허용할 예외 - 4
Sitemap: XML 사이트맵 위치
/robots.txt가 200으로 열리는지 봅니다
다른 HTML 페이지나 로그인 화면이 나오면 배포 설정을 확인합니다.
중요 페이지 경로가 Disallow인지 검색합니다
상품, 글, CSS·JS 리소스가 의도치 않게 차단되지 않았는지 봅니다.
차단된 페이지의 noindex 전략을 재검토합니다
검색결과 제외가 목표라면 봇이 noindex를 읽을 수 있어야 합니다. 크롤링 차단과 동시에 noindex를 넣어 해결하려 하지 마세요.
충돌을 개선하는 순서
- 페이지를 검색결과에 포함할지 제외할지 먼저 결정합니다.
- 포함할 페이지는 robots.txt에서 접근 가능하고 meta/X-Robots에 noindex가 없어야 합니다.
- 제외할 공개 HTML 페이지는 크롤링을 허용한 상태에서 noindex를 전달합니다.
- PDF처럼 HTML 태그를 넣을 수 없는 파일은 X-Robots-Tag를 사용합니다.
- 수정 뒤 robots.txt를 다시 열고, 페이지의 Meta Checker 기술 탭을 다시 검사합니다.
완료 체크리스트
- robots.txt와 noindex의 목적을 구분한다.
- meta robots와 X-Robots-Tag가 충돌하지 않는다.
- 중요 페이지와 렌더링 리소스가 의도치 않게 Disallow되지 않았다.
- 민감한 정보는 인증으로 보호한다.
- 수정 뒤 파일과 페이지를 각각 재검사했다.